工具介绍
Robots.txt 在线生成器是一款功能强大的工具,专为网站管理员、SEO 优化人员和网站开发者设计。它能够快速生成符合标准的 robots.txt 文件,帮助网站控制各种爬虫的访问行为,包括传统搜索引擎、AI 爬虫和 SEO 分析工具。
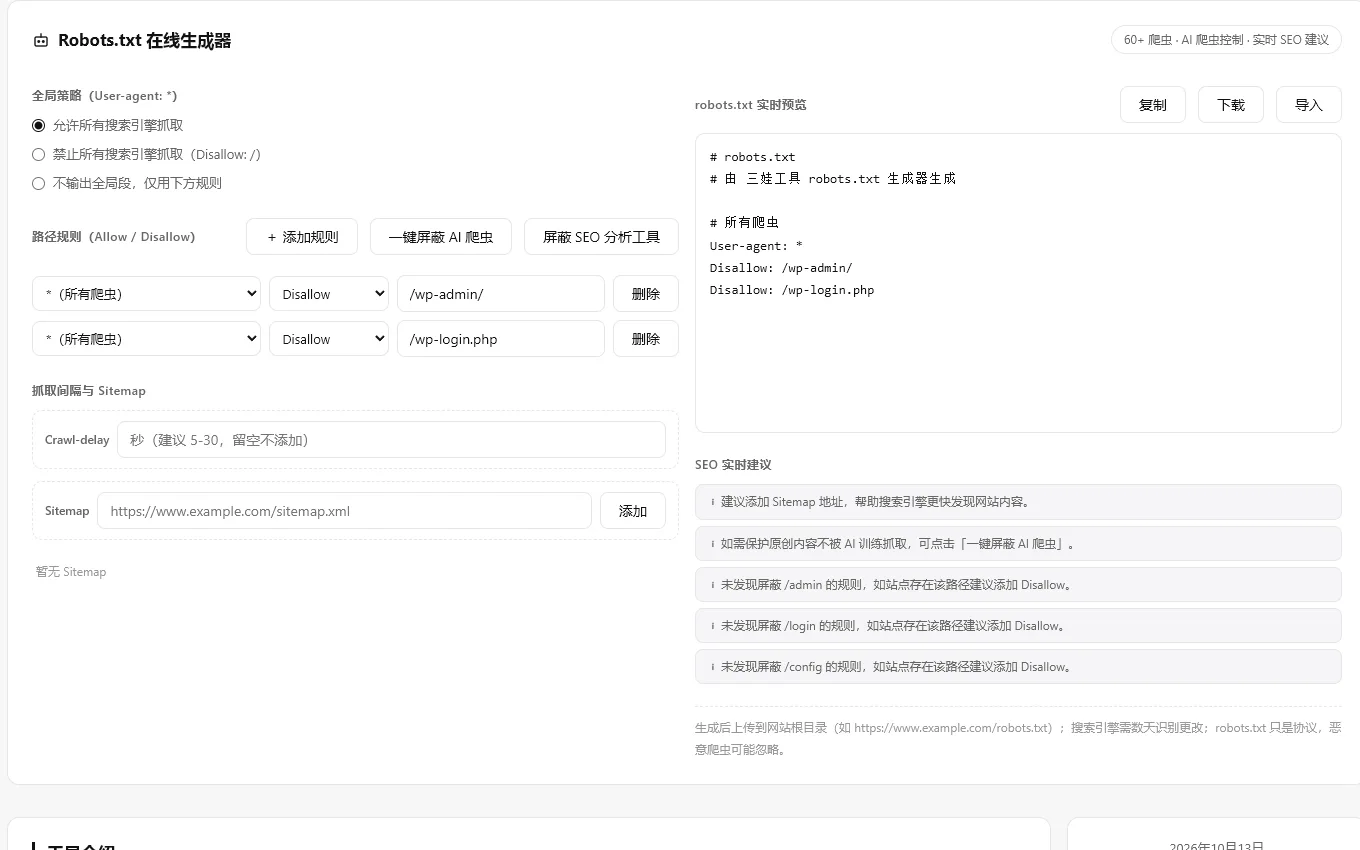
本工具内置四类 60+ 常见爬虫预设(国内引擎 / 国外引擎 / AI 爬虫 / SEO 工具),支持路径规则管理、多 Sitemap 配置、Crawl-delay 爬取间隔,并提供实时预览与 SEO 优化建议。支持一键屏蔽 AI 爬虫保护原创内容,也支持导入现有 robots.txt 文件编辑。全部生成在浏览器本地完成。
界面展示
功能亮点
- 多爬虫类型支持:支持传统搜索引擎、AI 爬虫、SEO 分析工具等 60+ 爬虫预设
- 精细控制:可对每个爬虫单独设置抓取规则,分类管理
- 路径规则管理:支持添加多条 Allow/Disallow 规则,自由增删
- 快捷操作:一键屏蔽 AI 爬虫 / SEO 分析工具,保护原创内容
- Sitemap 配置:可添加多个 Sitemap 地址,帮助搜索引擎发现内容
- 爬取间隔设置:可设置 Crawl-delay,控制搜索引擎抓取频率
- 实时预览与建议:配置变更实时生成预览,并给出 SEO 优化建议
- 导入导出:支持导入现有 robots.txt 编辑,生成结果可复制或下载
使用方法
- 设置全局策略:选择允许或禁止所有搜索引擎抓取(作用于 User-agent: *)
- 添加路径规则:点击「添加规则」设置 User-agent、指令和路径,或使用快捷屏蔽
- 配置 Sitemap 与间隔:添加 Sitemap 地址,设置 Crawl-delay 爬取间隔
- 复制或下载:使用「复制」或「下载」按钮获取 robots.txt,上传到网站根目录
适合人群
- 网站管理员:管理网站爬虫访问权限
- SEO优化人员:优化网站 SEO 策略
- 网站开发者:开发网站并配置 robots.txt
- 数字营销人员:控制爬虫行为以优化营销效果
- 内容创作者:保护原创内容不被 AI 抓取训练
常见问题解答(FAQ)
什么是ROBOTS.TXT文件?
位于网站根目录的文本文件,用于告诉搜索引擎爬虫哪些页面可以抓取、哪些不应该抓取,是网站与搜索引擎之间的协议。
为什么需要robots.txt?
控制爬虫行为、避免抓取敏感内容、减少服务器负担、提高抓取效率、优化 SEO 策略。
如何使用本工具生成?
设置全局策略 → 添加路径规则 → 配置爬虫与快捷屏蔽 → 添加 Sitemap → 设置爬取间隔 → 查看预览和 SEO 建议 → 复制或下载。
支持哪些爬虫?
国内搜索引擎、国外搜索引擎、AI 爬虫、SEO 分析工具四类 60+ 爬虫预设,包括 Googlebot、Baiduspider、bingbot、OpenAI GPTBot、ClaudeBot 等。
生成的文件如何使用?
上传到网站根目录,文件名为 robots.txt(如 https://www.example.com/robots.txt)。
是否支持导入现有文件?
支持,点击预览区域的「导入」按钮选择本地 robots.txt 文件,自动解析 User-agent、Allow/Disallow、Sitemap 与 Crawl-delay。
为什么要控制AI爬虫?
保护原创内容不被未授权用于 AI 模型训练、减少服务器负担、避免敏感信息被 AI 抓取、防止资源被过度消耗。
什么是USER-AGENT?
搜索引擎爬虫的标识符,如 Google 的 Googlebot、百度的 Baiduspider、OpenAI 的 GPTBot。
ALLOW和DISALLOW区别?
Allow 表示可以抓取指定路径;Disallow 表示不应抓取指定路径。
什么是SITEMAP?
XML 文件,告诉搜索引擎网站有哪些页面可抓取;在 robots.txt 中添加可帮助搜索引擎发现内容,需以 http:// 或 https:// 开头。
CRAWL-DELAY是什么?
告诉爬虫两次请求之间应等待的秒数,可减少服务器负担,建议 5-30 秒。
修改后会被立即识别吗?
搜索引擎需要时间发现和处理更改,通常需几天完全生效。
可以阻止所有爬虫吗?
robots.txt 只是协议,恶意爬虫可能忽略;敏感内容建议配合其他安全措施。
如何测试配置?
使用 Google Search Console 的 robots.txt 测试工具验证配置,或直接访问网站域名/robots.txt 查看生效内容。
更新日期:2026-11-02